
Contenu dupliqué PrestaShop : problème, causes et solutions


Un problème de contenu dupliqué sur PrestaShop vient rarement d'un seul réglage : paramètres d'URL, facettes, déclinaisons, migrations ou multiboutique peuvent tous créer des pages concurrentes. Repérer la cause réelle permet de choisir la bonne correction (canonique, 301, noindex ou robots.txt), puis d'en vérifier le résultat dans Search Console, sans fragiliser votre référencement.
Le contenu dupliqué menace-t-il le référencement ?
Les doublons ne sanctionnent pas une boutique, mais ils brouillent les signaux envoyés à Google. Il faut donc distinguer le risque réel des simples exclusions, qui sont souvent normales.
Ce que recouvre le problème
Dans une boutique PrestaShop, le contenu dupliqué prend deux formes : une même page accessible par plusieurs URL, ou un même texte répété sur des fiches distinctes. Le terme « duplicate content » décrit une ressemblance entre des contenus. À lui seul, il ne signifie pas une faute.
- Doublon d'URL : une page identique s'ouvre à plusieurs adresses.
- Doublon éditorial : la même description revient sur des produits différents.
- Quasi-doublon : des pages très proches qui ne diffèrent que par un détail.
- Similarité légitime : des pages qui se ressemblent mais répondent à des besoins distincts.
Selon Google, des doublons sur un même site e-commerce n'entraînent pas automatiquement de pénalité pour spam. Les moteurs de recherche ne punissent pas cette situation : ils doivent simplement choisir quelle version afficher.
Les effets possibles sur la visibilité
C'est justement ce choix qui pose problème. Google peut regrouper des pages très proches et afficher dans ses pages de résultats une autre URL que celle que vous préférez. Si la consolidation est incohérente, les signaux SEO se répartissent entre plusieurs versions au lieu de se concentrer sur la page que vous voulez mettre en avant.
Les URL redondantes ont aussi un coût en exploration : Google consacre du temps à des pages inutiles au lieu de parcourir les pages importantes du catalogue. Le suivi du référencement naturel devient en outre plus difficile à lire, car les performances sont réparties entre plusieurs adresses.
Les exclusions qui ne sont pas des erreurs
Un rapport d'indexation doit donc être lu avec prudence. L'exploration, l'indexation et le positionnement sont trois étapes distinctes : une URL non indexée n'est pas forcément un doublon. Les états « explorée, actuellement non indexée » et « détectée, actuellement non indexée » ne suffisent pas à prouver un contenu dupliqué.
Une ancienne URL ou une variante filtrée peut aussi être exclue volontairement, conformément à votre stratégie. Avant toute intervention, comparez l'état indiqué au résultat que vous attendiez.
Pourquoi PrestaShop génère-t-il des doublons ?
Les doublons viennent de trois sources : la manière dont PrestaShop construit ses adresses, la navigation par filtres et l'organisation du catalogue lui-même.
Plusieurs adresses pour une même page
Une page peut s'ouvrir à des adresses différentes sans que son contenu change. C'est le cas lorsque des paramètres de tri, de recherche ou de suivi sont ajoutés à l'URL : chaque variante affiche un contenu identique ou très proche.
- Chemins de catégorie : une fiche rangée dans plusieurs catégories peut avoir une adresse pour chaque chemin.
- Protocole et domaine : les versions HTTP, HTTPS, avec et sans www peuvent rester accessibles en parallèle.
- Héritage technique : une migration ou des URL simplifiées mal configurées laissent coexister des adresses anciennes et nouvelles.
Lorsqu'une fiche passe par plusieurs chemins de catégorie, les liens internes, la canonique et le sitemap doivent tous désigner la même version. Le thème ou un module peut aussi modifier les URL générées : c'est à vérifier en priorité après chaque mise à jour.
Facettes, filtres et pagination
La navigation à facettes multiplie encore les adresses. Les filtres de taille, de couleur, de prix, de matière ou de marque peuvent créer une URL pour chaque combinaison. Selon Google, cet espace d'URL peut ralentir la découverte des pages utiles. Un module de facettes peut en plus produire plusieurs URL pour une même sélection, selon l'ordre des paramètres.
Toutes ces pages n'ont pas le même statut. Les tris et les paramètres de suivi répondent rarement à une recherche autonome. À l'inverse, une page catégorie paginée affiche d'autres produits que la première page : ce n'est pas automatiquement un doublon. Les pages de promotions, de nouveautés ou de meilleures ventes doivent elles aussi être évaluées selon leur utilité propre.
Produits proches et boutiques multiples
Le catalogue peut lui aussi créer des doublons. Reprendre la description du fournisseur sur plusieurs fiches réduit leur différenciation. Un contenu unique précise les usages, les dimensions, les compatibilités ou les limites du produit, sans minimum de 150 mots. Les déclinaisons regroupent les variantes de taille ou de couleur sur une seule fiche produit. Une page séparée se justifie seulement si la variante correspond à une recherche propre.
En multiboutique, deux copies dans la même langue pour le même marché se font concurrence. Des offres destinées à des marchés distincts peuvent en revanche garder des URL séparées. Des langues différentes ne sont pas des doublons simplement parce que leur structure se ressemble. Ces cas sont traités dans la démarche d'optimisation SEO d'une boutique PrestaShop, qui commence par la correction des déclinaisons et des facettes.
Comment diagnostiquer les pages concurrentes ?
Un bon diagnostic se fait en trois temps : recenser les URL, contrôler ce que le serveur renvoie réellement, puis comparer ces résultats avec ce que Google a retenu.
Cartographier les URL du catalogue
Un audit SEO commence par l'inventaire des URL de produits, de catégories, de déclinaisons et de pages filtrées. Pour chaque page en double, il faut relever quatre éléments :
- Code HTTP : la réponse renvoyée par le serveur (200, 301, 404…).
- Redirections : leur destination et les éventuelles étapes intermédiaires.
- Canonique déclarée : l'URL indiquée comme version préférée.
- Sitemap : la présence ou l'absence de l'URL dans le fichier XML.
Commencez le crawl, c'est-à-dire l'exploration automatisée par un robot, sur quelques catégories représentatives. Vous repérez ainsi les pages dupliquées et les erreurs SEO sans parcourir indéfiniment les combinaisons de facettes. Avant toute modification massive, sauvegardez la configuration et notez les versions de PrestaShop, du thème et des modules. Le plan d'action de Prestashop France by Studio Web Design classe ensuite chaque correction selon l'impact attendu, la difficulté, les outils et le temps nécessaire.
Comparer les signaux réellement servis
Une fois l'inventaire établi, examinez une URL représentative : comparez son code source à la réponse HTTP, aux redirections, aux liens internes et au sitemap. Un réglage correct dans le back-office ne garantit pas que le HTML envoyé au navigateur le soit. La fiche doit contenir une seule balise rel=canonical, qui pointe vers une URL accessible et pertinente. Si la balise manque ou renvoie vers une ancienne adresse, le thème ou un module peut être en cause.
La correction dépend de la version utilisée. Sur PrestaShop 9, la variable canonique peut être vide si le contrôleur ne la définit pas. Les corrections faites autrefois dans le fichier header.tpl de la version 1.6 ne doivent pas être reprises sans vérification.
Confronter le catalogue à Google
Dans Search Console, le rapport « Indexation des pages » sépare les pages indexées des URL exclues. L'inspection d'URL compare, dans les données de la version indexée, la canonique déclarée à celle choisie par Google. Le rapport « Performances » indique les clics, les impressions et les requêtes, ce qui permet de repérer une page utile avant de modifier son indexation. L'audit SEO PrestaShop de l'agence compare les pages connues de Google aux pages réelles de chaque boutique. Il examine séparément chaque domaine, langue et sitemap.
Produits recommandés
Quelle correction choisir selon le cas ?
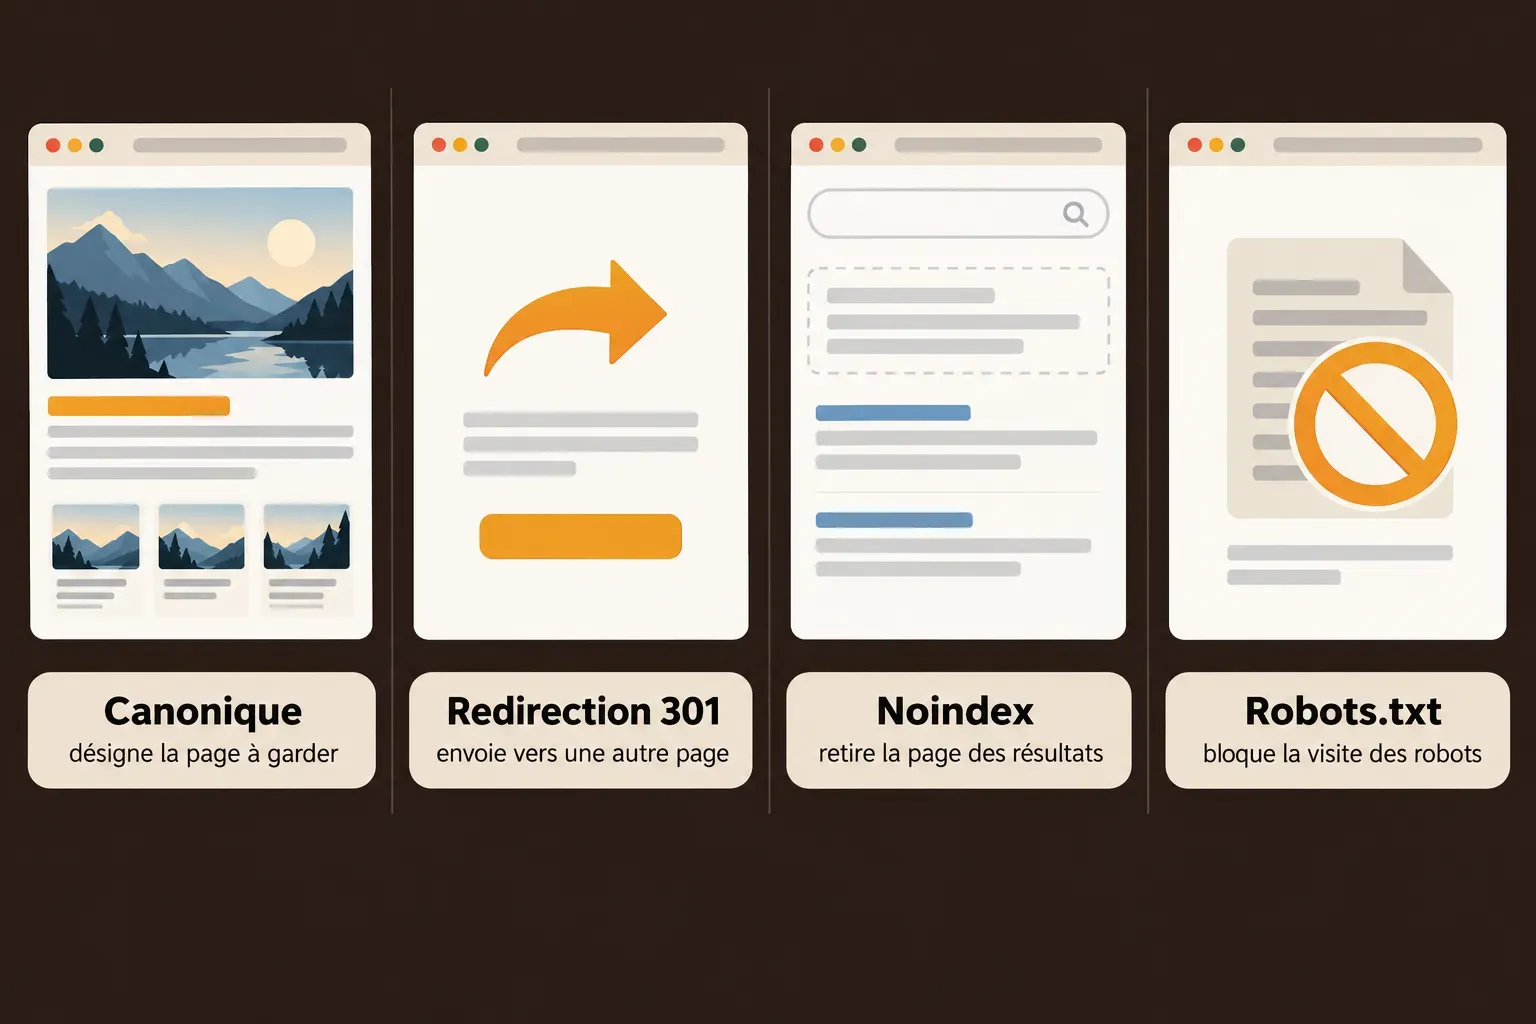
La canonique, la redirection 301, la directive noindex et le fichier robots.txt ont chacun un rôle précis. Ils ne sont pas interchangeables : le bon choix dépend de ce que la page doit devenir.
Conserver plusieurs URL avec une canonique
Lorsque des versions très proches doivent rester accessibles, la balise canonical (rel=canonical dans le HTML) indique l'URL canonique à privilégier. Google la traite comme un signal fort, pas comme un ordre. Une variante avec paramètre de suivi peut ainsi rester accessible tout en désignant la version principale. Pour que ce choix soit respecté, le sitemap et les liens internes doivent aller dans le même sens.
Pour éviter le contenu dupliqué sans masquer des pages utiles, adaptez la règle à chaque type de page. Une catégorie paginée qui affiche d'autres produits peut garder sa propre canonique. Une facette stratégique, si elle répond à une vraie demande, mérite une URL et un contenu distincts.
Remplacer définitivement une ancienne adresse
La redirection permanente 301 répond à un autre besoin : remplacer une ancienne URL par une destination équivalente. Contrairement à la canonique, elle envoie automatiquement l'internaute et le robot vers la nouvelle adresse.
Une fiche de produit remplacé durablement peut donc être redirigée vers son équivalent. En revanche, un produit temporairement indisponible ne doit pas être supprimé pour cette seule raison.
S'il n'existe aucun équivalent pertinent, une réponse 404 ou 410 vaut mieux qu'une redirection vers la page d'accueil. Contrôlez ensuite chaque règle pour éviter les boucles et les chaînes de redirections inutiles.
Limiter l’indexation ou l’exploration
Le noindex retire une page des résultats, mais Google doit pouvoir explorer la page pour lire cette directive. Selon Google, ce n'est pas la méthode recommandée pour choisir la version canonique parmi des doublons d'un même site. Le fichier robots.txt, lui, contrôle l'exploration et non la désindexation. Si vous bloquez une page avant que Google ait lu son noindex, la directive peut ne jamais être prise en compte.
Parmi les bonnes pratiques SEO appliquées par l'agence, le robots.txt sert à écarter les zones inutiles comme le panier ou l'administration, sans bloquer par erreur les produits et les catégories. Bloquer toutes les URL contenant « ? » écarterait aussi des sélections potentiellement utiles. Ces réglages font partie des solutions de SEO technique pour PrestaShop, qui comprennent aussi la gestion des canoniques.
Comment valider la correction dans le temps ?
Une correction se valide en deux temps : d'abord le contrôle technique, puis le suivi de la prise en compte par Google, qui demande plus de patience.
Tester après la mise en production
Dès le déploiement, vérifiez les réponses HTTP, les redirections, les canoniques, le HTML et le sitemap. Un résultat techniquement conforme ne prouve pas encore que Google l'a pris en compte. Testez au minimum les types de pages suivants :
- Fiches produits : une fiche simple et une fiche à déclinaisons.
- Catégories : une catégorie filtrée et une catégorie paginée.
- Contextes : une ancienne URL, ainsi que chaque boutique ou langue concernée.
Si le cache affiche encore l'ancien HTML, le vider peut faire apparaître la nouvelle balise. Cette opération ne corrige pas une règle canonique erronée et n'efface pas les URL déjà connues de Google.
Observer la prise en compte par Google
Selon Google, une nouvelle exploration peut prendre de plusieurs jours à plusieurs semaines, selon la page et la vitesse à laquelle elle est redécouverte. D'après la documentation de dépannage de Google, un groupe de pages dupliquées peut persister jusqu'à deux semaines après une correction de contenu, sans garantie de résolution au terme de ce délai.
Pendant ce temps, inspectez les URL prioritaires et comparez de nouveau les canoniques. Vous pouvez demander une nouvelle exploration, mais elle ne garantit ni une indexation rapide ni l'acceptation de l'URL souhaitée.
Réagir si le résultat reste inattendu
Si Google retient une autre canonique, cherchez les contradictions entre le HTML, les redirections, le sitemap et les liens internes. Vérifiez ensuite que les contenus des pages concernées sont réellement différents.
Si la correction échoue malgré tout, contrôlez que Googlebot accède bien à la page et regardez le HTML qu'il reçoit. Testez ensuite une nouvelle logique sur un petit groupe de pages avant de l'étendre à tout le catalogue.
Le retour du trafic ne suit aucun délai universel. Dans le cadre d'un accompagnement en référencement avec un expert dédié, les problèmes corrigés sont suivis dans les rapports SEO. Les performances avant et après déploiement y sont comparées en tenant compte de la saisonnalité et des changements commerciaux.
Foire aux questions
Un thème, un module SEO ou une surcharge de template peut modifier la balise finale, et deux composants peuvent même générer des balises concurrentes. Si possible, testez les modifications une par une sur un environnement de préproduction. Contrôlez de nouveau les URL après chaque mise à jour.
Oui. Une règle.htaccess incorrecte peut provoquer des redirections en boucle ou des problèmes d'indexation. Après correction, vérifiez les réponses HTTP, les redirections et les canoniques.
Pas toujours. Sur d'anciennes versions, un paramètre d'URL non reconnu pouvait laisser une page de catégorie accessible et indexable malgré ces règles. Vérifiez ce point sur la version que vous utilisez.
Prestashop France by Studio Web Design recommande de corriger d'abord les erreurs techniques fondamentales. Un audit technique réalisé avant les optimisations de contenu permet d'identifier les freins prioritaires.
C'est la recommandation de Prestashop France by Studio Web Design : chaque fiche produit devrait avoir une balise title unique, qui contient son mot-clé principal.
Partager cet article :